把视频交还给游戏时钟:自研跨平台播放器的帧调度与 GPU 管线
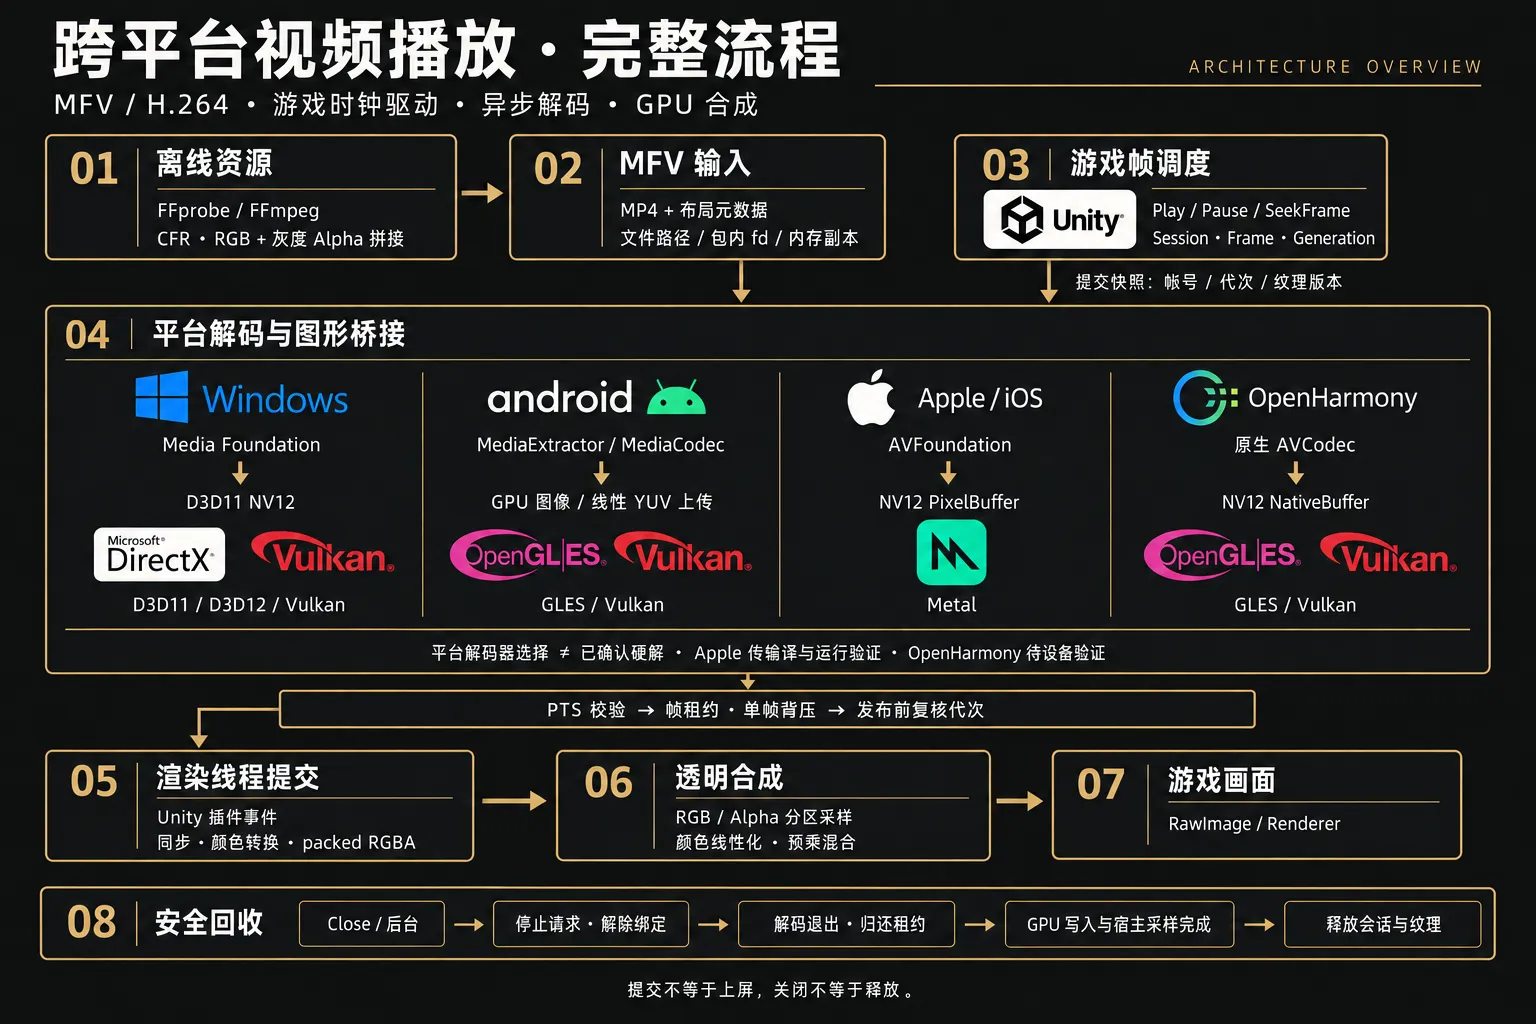
当视频进入登录背景、角色展示、动态 UI 与透明特效后,播放器的职责不再是从头播到尾的线性流媒体。它需要随界面频繁启闭,随剧情演出时间轴精确跳转,与实时 3D 场景混合渲染,并在切后台时释放大块显存、回前台时无缝恢复进度。
CRIWARE、AVPro Video 等成熟中间件提供了可靠的跨平台解码接入,却未能消除生命周期管理的内在复杂性。Unity 组件、原生会话、系统解码器与 GPU 显存往往各行其道,上层业务仍需修补繁琐的状态流转与释放时序。
以 CRIWARE 的 CriMana 为例,Stop() 仅发送异步停止请求,底层实例销毁必须显式调用 Dispose();应用切后台若涉及渲染挂起,还需使用 PauseOnApplicationPause(),底层 Player 甚至需自行注册 Unity 生命周期回调。普通暂停、后台暂停、停止与销毁的语义各自分散,接入方必须自行维护大量胶水代码以处理预热撤销、对象池复用与快速切歌。CRIWARE Player 官方文档。
AVPro Video 也有据可查:其 3.3.4 版本曾修复 Android ExoPlayer 在尚未执行 Play() 前调用 CloseMedia() 导致的内存泄漏,以及关闭媒体时的竞态崩溃。这印证了预热取消与快速切换并非罕见边缘分支,而是游戏客户端的高频日常场景。AVPro Video 官方版本记录。
更根本的矛盾在于时钟与画面的主导权:游戏逻辑 Tick 能否严格决定当前展示帧?Seek 成功究竟意味着解码器已产出样本,还是纹理已写入 GPU?多路并播占用多少显存,关闭后何时真正被操作系统释放?在 60 FPS 下,单帧仅约 16.67 ms,一次不当的同步阻塞就会导致卡顿;而当演出时间轴已跳转至第 240 帧,迟到的第 120 帧绝对不能再被错误地上屏。
这套自研播放器的核心设计是将帧调度、资源所有权与回收条件保留在游戏侧,让底层系统媒体框架专心负责解码,再通过原生图形接口桥接至 Unity。本文讨论的技术边界聚焦于:标准 MP4 容器封装的单路固定帧率(CFR)H.264 视频,无音轨,8 位 SDR,且具有明确的 RGB/Alpha 打包布局(音画同步与泛格式软解不在本文范畴;各平台支持边界见第 4 节)。
flowchart TB
    BUILD["离线处理工具<br/>探测 / 规范化 / RGB 与 Alpha 打包"] --> ASSET["MFV 资源<br/>MP4 + 布局元数据"]
    ASSET --> INPUT["资源输入<br/>路径 / 包内 fd 范围 / 内存副本"]
    GAME["游戏控制端<br/>UI / 演出时间轴 / 逻辑 Tick"] --> CONTROL["Unity 主线程<br/>播放意图 / 目标帧 / 请求代次"]
    INPUT --> DECODE["每会话工作线程<br/>系统解码 / PTS 校验 / 帧租约"]
    CONTROL --> DECODE
    DECODE --> GPU["渲染线程与 GPU<br/>平台桥接 / 颜色转换 / RGBA 提交"]
    GPU --> SHADER["MFV 材质<br/>RGB 与 Alpha 采样 / 合成"]
    SHADER --> OUTPUT["RawImage / Renderer"]
    GPU -.->|"已提交帧 / 代次 / 纹理版本"| CONTROL
    CONTROL -.->|"关闭"| RETIRE["异步回收器<br/>等待解码退出与 GPU 使用完成"]
    DECODE -.->|"归还租约"| RETIRE
    OUTPUT -.->|"解除绑定 / 标记最后使用"| RETIRE
下文沿这条管线,系统解析资源规范、时钟调度、异步解码、GPU 桥接、透明合成、显存核算与安全回收的协同机制。
1. 资源契约:先把素材变成可预测的资产
运行时对素材约定的猜测越少,后续的调度与渲染逻辑就越轻量。离线工具负责消化原始工程素材的差异,播放器按严格的协议读取,并在两端设立防御性校验。
1.1 从原片到 MFV
统一视频处理工具以 FFprobe 探测素材、以 FFmpeg 执行剪裁与转码,最终由导出层注入 MFV 专属元数据。流水线如下:
素材探测 → 时间与画布规范化 → RGB/Alpha 布局拼接 → H.264 编码 → 元数据注入与成品检查 → 发布。
| 阶段 | 关键处理 | 影响 |
|---|---|---|
| 输入规范化 | 锁定帧率、方形像素、裁剪缩放、剥离音轨 | 统一时间轴单位与渲染尺寸 |
| 透明布局 | RGB 与 Alpha 同步对齐,遮罩可选降采样与拼接 | 决定 Alpha 保真度与编码面积 |
| 编码转码 | 设定目标码率、恒定 GOP 结构与 Profile | 平衡文件体积、画质与随机寻帧开销 |
| 校验与发布 | 校验实际尺寸、总帧数、时间戳线性度与布局 | 杜绝元数据声明不符与半成品外溢 |
通用转换工具即使成功导出,也未必符合本播放器的前置假设。生产端需显式采用 CFR 模式,通过丢帧或复制帧消除可变帧率(VFR),并剔除音轨。带有镜头旋转或 HDR 标记的素材必须在离线阶段烘焙规范化,不可依赖运行时处理。
透明度必须直接提取自源文件的像素 Alpha 通道,严禁基于黑底色扣取。原片采用直通(straight)还是预乘(premultiplied)必须显式标记,该参数用于指示运行时 Shader 运算逻辑,转码过程本身不修改数值语义。
透明视频采用 RGB 与灰度 Alpha 同屏拼接方案,支持分别配置颜色与遮罩的采样分辨率,具体成本与采样策略见第 5 节。
1.2 标准容器中的游戏语义
MFV 沿用标准 MP4 容器组织媒体样本,在自定义 UUID Box 中记录渲染所需的几何与色彩元数据。这保证了底层系统解封装器能够直接识别音视频轨道,同时自研运行时能快速提取额外指导信息。直接修改普通 MP4 的后缀并不能生成合法的 MFV。
| 元数据字段 | 用途 |
|---|---|
encoded_size |
解码输出图像与分配 GPU 纹理的实际物理尺寸 |
display_size、rgb_rect |
最终呈现画面尺寸以及颜色区域在整图中的归一化坐标 |
alpha_rect、alpha_mode |
灰度遮罩区域坐标以及直通或预乘 Alpha 语义 |
frame_count、avg_frame_rate、time_base |
视频总帧数、有理数帧率以及时间基准单位 |
color |
BT.709、limited range 等色彩空间标准定义 |
显示尺寸不等于编码尺寸。拼接后的全图不仅决定了解码器的硬件规格要求,还直接决定了 GPU 纹理显存的分配大小。若遮罩使用了非对称降采样,高度并非简单减半,绝不能用显示尺寸代替编码尺寸去估算显存占用与硬解负载。
元数据解析器通过逐 Box 步进并跳过 mdat 媒体大包,无需将完整视频读取进内存即可完成解析。解析过程内置严格边界检查,覆盖 JSON 结构层级、重复键值、无效矩形范围以及区域重叠等异常。
1.3 整数帧的时间基础
设帧率为 ,总帧数为 ,首帧时间戳归零,则第 帧的理论时间戳为:
以常见的 FPS 为例,第 300 帧对应 10.01 秒。使用有理数分子分母表达帧率,可彻底消除将帧率近似为 30 FPS 带来的长期漂移误差。
非循环模式下,由游戏时间计算目标帧的公式为:
视频总物理时长为 ,最后一帧的起点时间为 。循环播放时,先将时间求模折算至单一周期内,再计算目标帧。
API 层面提供整数帧接口 SeekFrame(k),底层自动转换为原生时间单位。例如 Windows Media Foundation 采用 100 ns 刻度,换算时必须校验数值溢出并控制微小截断误差。
常规运行时打开仅进行轻量级元数据与容器头校验;只有开启 DebugValidation 时才会遍历抽检各帧样本。这兼顾了运行时的无感知启动,也将码流损坏的排查前置在制作验收阶段。
2. 帧调度:控制目标,也识别迟到的结果
资源层明确了帧与时间的映射,调度层的核心任务则是将业务想要的帧与当前渲染管线中已提交的帧清晰隔离。
2.1 自动时间与外部 Tick
自动播放模式通过 Time.realtimeSinceStartupAsDouble 配合时钟锚点推进进度,暂停恢复时重新校准锚点,避免将切出时间计入播放历程。该时钟独立于 Time.timeScale,默认不受游戏慢动作缩放影响。
启用 ManualUpdate 后,外部驱动(如剧情 Timeline、状态机)通过 SeekFrame 明确指定目标帧。需要指出,这种外部控制本质上是对播放时间和帧请求的异步编排:主线程发起请求后,由原生工作线程解码,并在帧末通过渲染事件提交至 GPU,它并非一个同步完成解码上屏的阻塞调用。
当 60 FPS 游戏驱动 30 FPS 视频时,连续两个游戏帧会请求相同的视频帧号。内部常规请求会合并幂等目标,避免冗余消耗;但显式调用的 Seek 每次都会递增代次。因此,手动驱动逻辑应当在目标帧真正变更时才调用请求。
若一次逻辑跳转跨越了多个视频帧,播放器会直接定位至目标帧,但由于 H.264 的 GOP 帧间依赖,底层解码器仍可能需要顺序解码前置参考帧。在此期间,游戏画面保持当前帧不变,直到新帧就绪。高精度的寻帧指令并不能抹平底层解码的物理耗时;对于有严苛逐帧对齐要求的预览工具,应当等待当前代次完成确认后再推进时间轴。
2.2 请求代次与完成条件
当业务先后下发第 120 帧与第 240 帧请求时,旧任务可能已在原生线程开始解码。此时不强求立即强杀在途解码,但必须通过版本机制废除旧结果的发布资格。
sequenceDiagram
    participant G as 游戏主线程
    participant W as 解码工作线程
    participant R as 渲染线程
    G->>W: 帧 120,代次 41
    Note over W: 开始定位与解码
    G->>W: 帧 240,代次 42
    W->>W: 检查代次,丢弃旧结果
    W-->>R: 帧 240 的租约,代次 42
    R->>R: 发布前再次检查代次
    R-->>G: 已提交帧 240,代次 42,纹理版本递增
方案引入单调递增的 64 位代次(Generation)标记每一次请求。仅当以下条件全部满足时,C# 托管层才判定该次帧请求已顺利完成提交:
进行跨会话比对时,还必须叠加 Session 句柄一致性校验,防止对象池复用时误判历史残留状态。
在工程观测上必须严格区分三个时间节点:解码完成(原生解出数据)、提交 GPU(纹理更新完毕)、屏幕上屏(显示器光栅化扫出)。确认提交仅代表 GPU 纹理已就绪供下一次 Draw Call 采样,并不等同于当前游戏帧的人眼可见延迟。
3. 异步解码:精确定位如何避免阻塞主线程
3.1 异步调度与软硬解是两个维度
每个播放会话独立维护一个原生工作线程,负责文件解封装、寻帧和驱动系统解码器;主线程仅通过轻量命令环与其通信。
| 模式 | 计算核心 | 典型流程与开销 |
|---|---|---|
| 软件解码 | CPU 通用核心 | 输出 YUV 内存平面,需占用总线带宽上传至 GPU 显存 |
| 硬件解码 | 专属视频硬解单元(NVDEC、MediaCodec 等) | 直接输出 GPU 显存表面,仍涉及跨上下文转换或显卡内部拷贝 |
将调用移入工作线程只是避免了主线程挂起,并不等同于启用了硬件加速;拿到 GPU 纹理句柄,也不意味着全流程免去了内存拷贝。软硬解管线都必须携带帧号、PTS 与代次信息,接受相同的生命周期校验。
工作线程在循环关键节点执行代次核对,属于协作式响应。对于已经陷入系统驱动底层的同步阻塞接口,仍需等待其正常返回方可退出,因此异步化无法实现纳秒级的绝对中断。
3.2 连续读取与随机定位
H.264 视频的随机跳转通常需要先 Seek 至前一个最近的关键帧(IDR/I 帧),重建参考图像列表,再快速顺序追帧至目标 PTS。定位耗时取决于 GOP 间距与码率。
以 Windows 实现为例,H264Decoder::at 维护 nextFrame 状态计数:当请求帧恰好为连续下一帧时,直接推进读取;当发生跳转时,调用 SetCurrentPosition,并丢弃到达目标帧之前的解码输出。当前逻辑容许一个基准时间单位的量化浮动;若解码越过目标点仍未匹配 PTS,则立即报错,坚决不用临近画面冒充目标帧。
较短的 GOP 结构有利于缩短随机寻帧延迟,但会牺牲压缩比;长 GOP 在逆向播放或高频跳跃时会造成显著的追帧抖动。资源制作阶段需要在此取得平衡。
3.3 单帧租约与背压
为防止解码线程无限制缓冲导致显存飞涨,系统引入了单帧租约(Frame Lease)机制:当前会话至多允许持有一个未归还的输出租约。
flowchart LR
    A["解码目标帧"] --> B["发布租约"]
    B --> C["上传 / GPU 转换或拷贝"]
    C --> D["确认不再使用"]
    D --> E["归还租约"]
    E --> A
CPU 内存缓冲必须维持存活,直至 GPU 上传完成;GPU 显存表面也必须等待渲染格式转换结束后方可释放。一旦消费端未确认归还,解码工作线程将暂停产出新帧,从而形成自然背压。该机制杜绝了内存堆积,但同时也对单帧跨线程周转效率提出了更高要求。
4. GPU 桥接:统一语义,保留平台差异
控制层对外抹平了调度接口,但解码帧最终如何转化为 Unity 可采样的纹理,取决于各操作系统的底层图形接口与驱动架构。
| 平台 | 媒体接口与输出路径 | 当前边界与取舍 |
|---|---|---|
| Windows | Media Foundation → D3D11 NV12 → D3D11 / D3D12 / Vulkan 桥接 | 优先走硬件加速表面,通过视频处理器色彩转换;无独立 CPU 内存软解兜底 |
| Android | MediaExtractor / MediaCodec → Surface 或线性 YUV 上传 → GLES / Vulkan | Surface 遇到异常时回退线性 I420/NV12 平面;硬件状态需结合实机测试 |
| Apple | AVFoundation → NV12 PixelBuffer → Metal 纹理缓存映射 | 依赖 Metal 跨平面映射;当前工程入口主要面向 iOS 验证 |
| OpenHarmony | 原生解封装与 AVCodec → NV12 NativeBuffer → GLES / Vulkan | 通过 NativeBuffer 共享表面;依赖特定硬件平台驱动支持 |
4.1 Windows:GPU 表面转换与多图形 API 桥接
Media Foundation 的 Source Reader 挂接 D3D 设备管理器,启用 DXVA 硬件变换以获取 NV12 显存表面。D3D 设备管理器、硬件 MFT 配置。
获取的 D3D11 采样样本经由 Direct3D 视频处理器执行色彩空间转换,输出为 RGBA 格式。对于非 D3D11 宿主(如 D3D12 或 Vulkan),运行时在同一物理适配器上建立共享句柄与跨 API 围栏进行资源交换。此方案彻底省去了像素在 CPU 内存中的往返拷贝,但仍存在显卡内部从解码表面到渲染纹理的转换消耗。
4.2 Android:应对驱动差异的输出回退
Android MediaCodec 提供直接输出至 Surface 与暴露内存缓冲两种模式。MediaCodec 官方文档。
实测发现,部分模拟器(如 MuMu)或特定 SoC 在 Surface 模式下可能强制采用 RGB565 格式,破坏了色彩动态范围与 Alpha 灰度精度。针对此类设备,播放器动态回退至线性 I420/NV12 原始输出模式,由 CPU 上传各个平面至 GPU,再通过 Compute Shader 或 Fragment Shader 执行 BT.709 转换。对于非标准的厂商平铺格式则直接报错中断,杜绝花屏隐患。
4.3 Apple 与 OpenHarmony 的接入特征
Apple 路径利用 CoreVideo Metal 纹理缓存直接将 CVPixelBuffer 的两个 Y/UV 平面映射为 Metal 纹理对象,极大降低了转换开销。OpenHarmony 则依赖系统 NativeBuffer 实现跨进程的显存无拷贝共享。
跨平台的纯 CPU 软解回退存在相当大的代价:不仅需要管理依赖库体积,还要应对会话重建、CPU 发热与带宽瓶颈。因此在架构设计上,当前策略优先保障主流硬解通路的健壮性,而非无条件引入全套 FFmpeg 运行时。
4.4 宿主渲染线程提交
Unity 原生图形插件接口要求所有直接操作 GPU 资源的行为必须排入渲染线程执行,杜绝跨线程调用污染图形管线上下文。Unity 低级原生插件接口。
在帧末通过 IssuePluginEventAndData 排入原生渲染回调。桥接层负责校验目标纹理可写性、执行跨 API 同步,并在提交完成前夕再次核对代次,确保发布给材质采样的纹理与当前请求严格同代。
5. 透明视频:编码策略、成本与合成
游戏 UI 和特效中广泛使用带透明通道的短视频。若将 RGB 颜色与 Alpha 遮罩拆分成两个独立视频文件解码,极难在移动端保证两路解码器帧级同步,一旦错开一帧就会在边缘引发严重的黑边或透视穿帮。
MFV 采用单流同屏拼接策略,使颜色与透明度共享相同的码流、PTS 与解码上下文。
5.1 单流拼接策略与编码面积
当前 MFV 将彩色画面置于上方,将 Alpha 灰度遮罩置于下方,并在两者之间保留两行黑像素隔离带,避免双线性过滤采样时颜色渗透。解码后由 Shader 分别按 UV 采样并重新合成。
工具默认对遮罩区域采用宽高各折半(0.5 缩放)的离线降采样处理以节约码率。以 1920×1080 尺寸的源片为例,RGB 区域占 1920×1080,下方遮罩区域实际为 960×540;为保证矩形整图编码,遮罩右侧需填充黑像素,拼接后的物理画面尺寸为 1920×1622:
总编码面积约为原始画面的 1.5 倍(而非直觉上的 1.25 倍)。该整图必须整体参与硬解、显存分配与色彩转换。遮罩降采样是否满足美术品质要求,需在柔和边缘、光晕与细小粒子场景中重点检验。
5.2 备选优化方向评估
| 方案 | 预期收益 | 工程代价与当前取舍 |
|---|---|---|
| 紧凑排布遮罩 | 消除半尺寸遮罩右侧的填充黑区,压低整体编码面积 | 需对遮罩进行切片与异构重排,Shader 采样映射变复杂,需额外处理接缝 |
| 颜色与 Alpha 独立双流 | 各自按需设置尺寸与 Profile,无无效填充区 | 运行时需维持双倍解码器,双路 Seek 同步与回收复杂度极高 |
| 原生 Alpha 格式(如 HEVC with Alpha) | 单流内置 Alpha 层,硬件级原生支持 | 跨平台兼容性差(Apple 支持良好,Android/Windows 缺乏统一标准),不满足多端一致性 |
| 保留 YUV 平面直接采样 | 省去转换为 RGBA 中间纹理的显存与带宽消耗 | 增加材质 Shader 多平面采样与色彩转换计算,跨 API 桥接较复杂,当前仍保留 RGBA 中间输出 |
综合多端稳定性与工程复杂度,单流同屏拼接仍是当前平衡性最好的方案。
5.3 严格限制区域采样
双线性过滤在纹理贴图边界会与邻近像素混合。MfvUv 函数将 UV 严格限定在有效像素中心以内。设有效区域起始像素为 、区域尺寸为 、拼接整图尺寸为 、局部归一化坐标为 :
拼接纹理关闭 Mipmap。若强行生成 Mipmap,低层级低分辨率纹理会将上方颜色与下方遮罩彻底混合,破坏边缘合成。
5.4 色彩线性化与预乘合成
YUV 样本转换至 Packed RGBA 纹理后,材质仅读取遮罩区域的红通道作为透明度数值,不再执行二次范围扩展或传递函数。
项目使用线性色彩空间(Linear Space)时,Shader 负责色彩逆传递。对于预乘素材,需先在存储值域解除预乘,再做色彩空间线性转换,最后乘以 Alpha 输出;当 Alpha 为零时颜色直接置零,防止除以零产生 NaN。
材质使用混合模式 Blend One OneMinusSrcAlpha,对于线性空间非预乘素材与不透明背景,最终上屏颜色为:
各平台色彩验证必须涵盖色彩空间矩阵、Limited/Full 范围、传递函数与预乘语义,杜绝色彩发灰、泛白或半透明发黑。
6. 内存:按资源层次核算,按编码尺寸估算
压缩后的 MP4 文件大小无法作为显存估算依据。解码过程中的解封装数据、参考帧缓存、中间表面和 Unity 纹理均有独立的生命周期与内存驻留。
6.1 显存与带宽基准量级
以标准 8 位 NV12 与 RGBA8 为基准,单帧无额外压缩时的纯像素占用公式为:
以典型的 1920×1080 编码尺寸 为例:
| 资源单元 | 理论显存量级 |
|---|---|
| 单帧 NV12 解码表面 | 约 2.97 MiB |
| 单帧 RGBA8 渲染纹理 | 约 7.91 MiB |
| 缓存 30 帧 RGBA8 历史样本 | 约 237.3 MiB |
| 60 FPS 下全带宽更新 RGBA8 | 约 474.6 MiB/s 显存吞吐 |
若加上透明上下拼接,物理面积增大至 1.5 倍,上述显存与总线吞吐需求相应等比放大。多实例并播时,必须将解码器自身的参考帧池与管线双缓冲一同纳入显存预算核算。
6.2 降低位深的精度代价
将输出纹理从 RGBA8(32 位/像素)降至 RGB565(16 位/像素),1080p 单张纹理理论显存由 7.91 MiB 减半至 3.96 MiB。Microsoft 像素格式定义。
然而此方案在透明拼接素材上存在明显缺陷:RGB565 的 R 通道仅有 5 位(共 32 个量化阶),用于表达 Alpha 遮罩会导致半透明边缘、烟雾与渐隐效果出现严重的色阶断裂与台阶效应。因此,除纯不透明背景视频外,透明播放器当前仍强制输出 RGBA8。
6.3 输入源所有权与并发配额
MediaInput 类型 |
所有权与内存特征 |
|---|---|
| 磁盘文件路径 | 按需流式读取,几乎无额外常驻内存 |
包内 fd + offset + length |
持有描述符直接流式映射,无冗余内存拷贝 |
内存字节数组(byte[]) |
打开时需深拷贝至原生堆内存,在视频关闭前产生双倍内存常驻 |
Android 优先通过 AssetManager.openFd 访问未压缩资源,OpenHarmony 通过 rawfile 描述符直连,规避将整个文件解压到内存中。
并发控制方面,除了设置最大会话上限(如 Windows 默认 8 个槽位),还需建立基于像素面积的总预算管理。四路 4K 视频的显存压力远超八路 480p 视频;所有会话必须在确认完全回收后才归还配额。
7. 生命周期:关闭返回之后,谁继续持有资源
在游戏快速切换 UI 时,上层调用 Close() 时工作线程可能正在解码,GPU 可能仍在执行格式转换,材质甚至还在执行光栅化采样。若直接同步销毁会导致管线崩溃,若强行阻塞等待则会导致主线程掉帧。
7.1 意图与状态正交解耦
播放器将底层硬件物理状态与上层业务意图明确解耦。底层状态包含 Idle、Opening、Preparing、Ready、Closing、Faulted、Disposed;进入 Ready 后再细分 Playing、Paused、Seeking、Ended。
当用户在打开(Opening)阶段下发 Pause,底层状态继续准备,完成后直接进入 Paused;在关闭(Closing)阶段下发 Play,播放器会等待旧资源回收彻底完成,再自动触发新会话开启。首帧必定经历一次完整的 Seeking,只有当前目标帧实际提交后才启动播放时钟,防止将初始化与解码延迟计入视频流逝时间。
7.2 安全回收与 GPU 栅栏
插件完成纹理写入并不代表 GPU 已完成材质采样,必须等待 GPU 执行完全部绘制命令。
flowchart TB
    CLOSE["Close / Disable / Destroy"] --> DETACH["停止新工作<br/>解除自有输出绑定"]
    DETACH --> CANCEL["通知解码取消"]
    DETACH --> MARK["帧末排入宿主最后使用标记"]
    CANCEL --> WORKER["工作线程退出<br/>帧租约归还"]
    MARK --> GPU["确认插件写入与宿主采样完成"]
    WORKER --> RETIRED["原生会话 Retired"]
    GPU --> RETIRED
    RETIRED --> RELEASE["回收句柄、纹理与材质"]
D3D11 通过 Event Query 轮询完成状态,Metal 与 Vulkan 通过专属 Fence/CommandBuffer 回调确认。VideoRetirement 异步管理器接管生命周期终止的资源,待原生解码线程安全退出且 GPU 围栏信号被触发后,方才安全销毁 Unity 纹理与底层句柄。
对于自定义材质采样者,上层业务需在组件销毁前主动解绑,避免悬空采样已废弃纹理。
7.3 前后台切换与异常容错
客户端切后台时,播放器记录当前播放进度与意图,主动关闭会话并释放全部解码表面与临时纹理;回到前台后按需重建会话并恢复进度。若遭遇 GPU 设备丢失(Device Lost),系统进入 Faulted 状态,通知业务层显式重试,避免静默黑屏。
在 Unity 编辑器退出或域重载(Domain Reload)期间,退出管理类执行安全排空(Drain),设置最大超时门限,防止非托管动态链接库卸载引发宿主崩溃。
总结
自研游戏视频播放器的核心价值,在于让复杂管线具备确定性与可观测性:
- 渲染迟到时,可清晰定位是 I 帧追帧开销、线程调度延迟还是 GPU 提交等待。
- 显存上涨时,可明确界定是内存输入副本、硬解参考帧表面还是待回收队列滞留。
- 透明边缘异常时,可追溯是色彩空间转换、线性化去预乘还是双线性采样外溢。
将帧调度归于游戏时钟,将解码交付系统原生框架,将生命周期交付异步安全回收,视频才能真正作为受控的表现单元,无缝融入现代游戏引擎的渲染体系。
 微信
 支付宝